AI 聊天機器人真的能改善健康嗎?JAMA 隨機臨床試驗揭露「使用率高,不等於療效好」
2026 年 11 月 16 日|人工智慧、臨床試驗與醫學大數據
近年生成式人工智慧快速進入醫療領域。從 ChatGPT 到各種專門設計的醫療聊天機器
 |
人,越來越多患者利用 AI 詢問疾病、治療、藥物副作用與健康管理問題。
然而,對醫學研究者而言,真正重要的問題不是 AI 有多少使用者,而是:使用 AI 之後,患者的健康是否真的變好了?
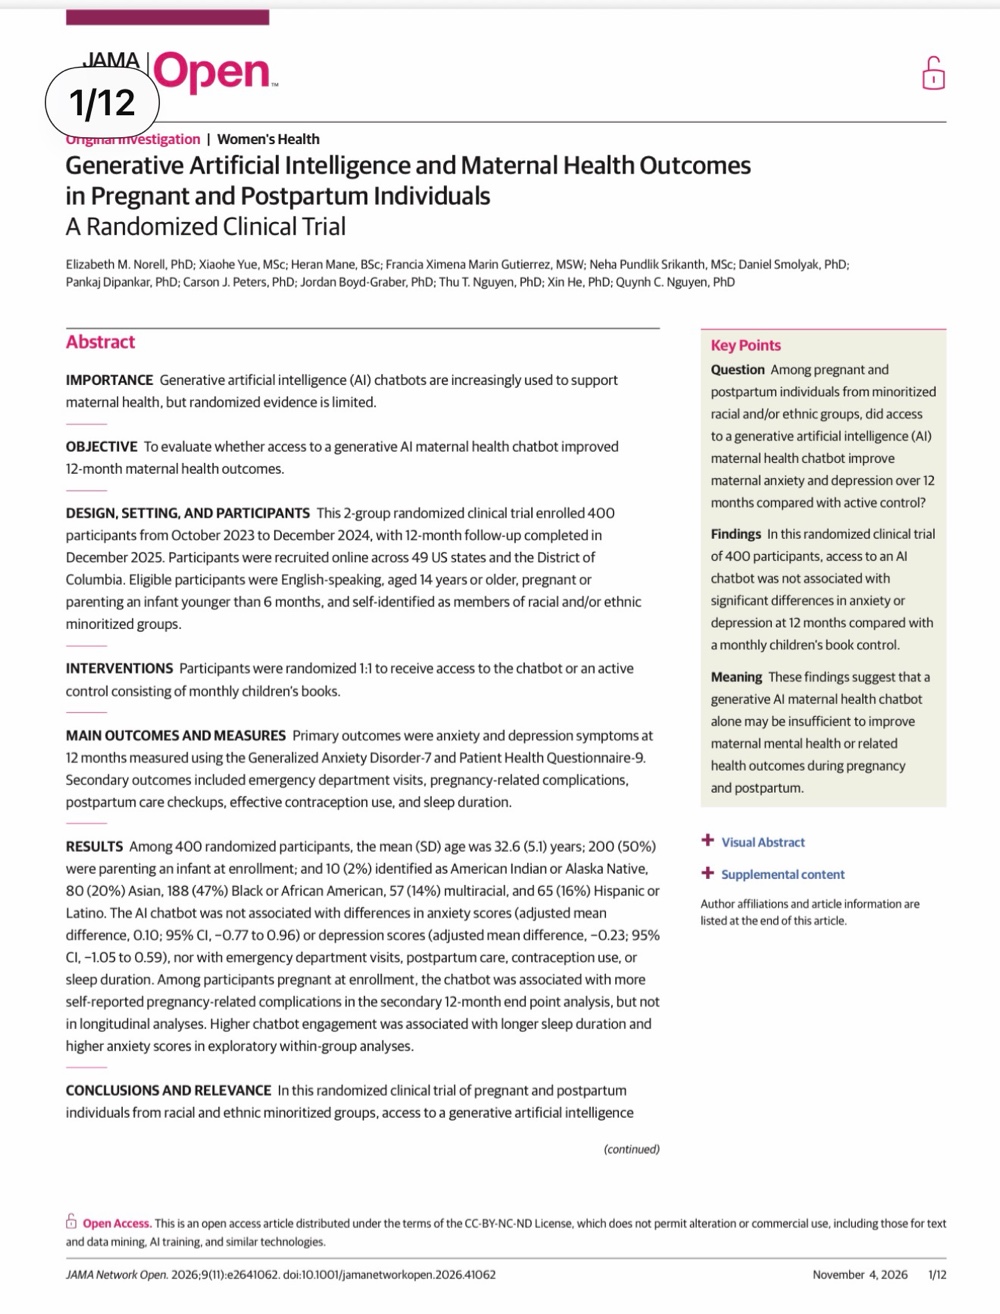
2026 年 11 月 4 日,Norell 等人在 JAMA Network Open 發表一項隨機臨床試驗,提供了非常值得思考的研究結果。
一、研究背景
懷孕與產後期間,許多女性面臨焦慮、憂鬱、睡眠不足及育兒壓力。
傳統醫療體系可能無法隨時提供健康諮詢,而生成式 AI 聊天機器人具有全天候互動、容易取得及相對低成本等潛在優勢。
但這些優點是否能轉化為實際的健康改善,必須透過嚴謹的臨床研究驗證。
二、研究設計
這是一項兩組平行、隨機對照臨床試驗。
研究於 2023 年 10 月至 2024 年 12 月招募 400 位美國孕婦或產後育兒者,並於 2025 年 12 月完成 12 個月追蹤。
參與者來自美國 49 州及華盛頓特區,符合資格者為年滿 14 歲、使用英語、處於懷孕期間或正在照顧未滿六個月嬰兒,且自我認定屬於研究指定的少數族裔群體。
受試者以 1:1 隨機分派至:
- AI 組: 可以使用生成式 AI 母嬰健康聊天機器人。
- 主動對照組: 每月收到兒童讀物。
主要終點為第 12 個月的焦慮與憂鬱症狀,分別使用 GAD-7 及 PHQ-9 量表評估。
次要終點包括急診就醫、懷孕相關併發症、產後照護、避孕措施及睡眠時間。
三、主要研究結果
研究共有 400 人隨機分派,其中 380 人完成第 12 個月問卷,或至少提供一項第 12 個月結果資料。
主要結果如下:
|
主要終點 |
AI 組相對對照組調整後平均差 |
95% 信賴區間 |
|
焦慮(GAD-7) |
+0.10 |
−0.77 至 0.96 |
|
憂鬱(PHQ-9) |
−0.23 |
−1.05 至 0.59 |
兩個主要終點的信賴區間均包含零,未證實 AI 介入具有統計顯著的改善效果。
此外,研究亦未發現急診就醫、產後檢查、有效避孕措施使用及睡眠時間等多數次要結果有明顯改善。
值得注意的是,在部分次要分析中,AI 組自述懷孕相關併發症較多,但這個結果未在縱向分析中重現,因此不能據此認定 AI 增加懷孕併發症風險。
四、最值得注意的現象:使用率高,不代表健康改善
在 AI 組中,納入使用情況分析的受試者有 98.4% 至少提出過一個問題,詢問次數中位數為 119 次。
這代表研究中的 AI 工具確實獲得相當程度的使用。
但即使使用者持續與 AI 互動,研究仍未證實整體焦慮或憂鬱獲得顯著改善。
探索性分析甚至發現,使用 AI 較頻繁的參與者,焦慮分數較高。
不過,這屬於觀察性關聯,不能認定 AI 造成焦慮。另一種可能是原本焦慮程度較高的人,更需要反覆向 AI 尋求資訊或協助。
這正是醫學研究中必須區分相關性與因果關係的重要例子。
五、從臨床試驗方法學看研究限制
第一,這項研究評估的是特定母嬰健康聊天機器人,而不是所有生成式 AI 系統。
第二,研究採用主動對照組,而非完全不接受額外介入的患者。每月收到兒童讀物,以及部分研究人員的聯絡,本身也可能帶來支持作用。
第三,主要結果依賴患者自我回報量表,受基線症狀、社會支持與其他生活因素影響。
第四,研究只納入特定美國族群與英語使用者,因此結果不能直接外推到所有國家、疾病或醫療環境。
第五,部分 AI 安全警示會由研究人員審查,必要時提供後續聯繫與轉介,因此這也不是完全無人監督的 AI 介入。
所以這篇研究所支持的結論是:在這項特定介入與研究族群中,尚未證實 AI 聊天機器人能改善一年後的焦慮與憂鬱,而不是所有醫療 AI 都沒有效果。
六、對風濕免疫科與 AI agents 的啟示
風濕免疫疾病具有慢性病特性,患者經常需要長期服藥、監測症狀及處理藥物副作用。
未來 AI agents 可能應用於類風濕性關節炎、僵直性脊椎炎、乾癬性關節炎及紅斑性狼瘡等疾病的患者衛教與長期追蹤。
但是,如果只是讓患者每天與 AI 聊天,並不能保證疾病控制更好。
真正值得研究的,是 AI 能否改善臨床結果,例如:
- 降低疾病復發及住院風險。
- 提高適當的藥物持續使用率。
- 改善患者生活品質與日常功能。
- 減少醫師文書負擔,同時維持醫療安全。
- 協助及早辨識需要醫師介入的危險訊號。
未來可以設計多中心隨機臨床試驗,比較標準照護與結合 AI agents 的照護流程。
同時利用電子病歷、疾病登錄資料及真實世界資料,長期追蹤患者的醫療使用、疾病活動度及重要安全性結局。
對這類研究而言,AI 是否有臨床醫護團隊監督、患者實際使用程度,以及不同疾病活動度患者的治療反應,都值得事先規劃。
七、我的觀點:醫療 AI 應該從展示能力走向證明效益
目前許多醫療 AI 研究強調模型的準確率、AUC、回答正確率與使用者滿意度。
這些指標有其必要性,但並不足以證明 AI 具備實際臨床價值。
未來真正重要的研究,應該評估導入 AI 之後,是否改善臨床決策及患者結果。
我們也應該重視 AI 可能帶來的意外後果,例如錯誤建議、過度依賴、資訊不一致,以及對醫療資源使用的影響。
這些問題需要嚴謹的隨機試驗、真實世界研究及持續的安全監測才能回答。
八、結論
這項刊登於 JAMA Network Open 的研究,並不是證明醫療 AI 沒有未來,而是提醒我們,技術的普及不能取代科學證據。
生成式 AI 可以改善資訊取得方式,但改善資訊取得,與真正改善患者健康,是兩個不同的研究問題。
醫療 AI 的成功,不應只看有多少人使用,而應看有多少患者真正因此受益。
參考文獻
Norell EM, Yue X, Mane H, et al. Generative Artificial Intelligence and Maternal Health Outcomes in Pregnant and Postpartum Individuals: A Randomized Clinical Trial. JAMA Network Open. 2026;9(11):e2641062.
DOI:https://doi.org/10.1001/jamanetworkopen.2026.41062
原始全文:https://jamanetwork.com/journals/jamanetworkopen/fullarticle/2856248
ClinicalTrials.gov:NCT06053515
文章標籤: 人工智慧、生成式 AI、AI Agents、臨床試驗、醫學大數據、真實世界研究、風濕免疫科、智慧醫療、JAMA Network Open